در مقایسه هوش مصنوعی برای کدنویسی، انتخاب به نوع کار، درستی خروجی و مسیر مصرف بستگی دارد. Claude، ChatGPT، Gemini و GLM را باید با درخواست و تست یکسان سنجید و بعد درباره اشتراک تصمیم گرفت.
این راهنما قابلیتهای مستند ابزارها را کنار نمونهای مشترک از تولید کد و رفع خطا میگذارد تا خودتان مقایسه را اجرا کنید. اعداد سبد خرید، پاسخ مرجع مسئلهاند و جدولها درباره امکانات و معیار انتخاب حرف میزنند، نه رتبه عملکردی.
مقایسه هوش مصنوعی برای کدنویسی را از کار خودتان شروع کنید
قرار است یک تابع بنویسید یا اشکال پروژهای موجود را پیدا کنید؟ پاسخ این سؤال انتخاب را عوض میکند. برای فهمیدن یک حلقه پایتون، گفتوگو درباره کد نقطه شروع معقولی است، اما وقتی محاسبه سبد خرید را تغییر میدهید، باید فایل اصلاحشده و نتیجه اجرای آن را هم ببینید.
معیار اصلی، رعایت قرارداد مسئله است. قرارداد یعنی توافق روشن درباره ورودی، خروجی و رفتار برنامه در وضعیت خطا. تابعی که جواب نمونه را درست میدهد، اما ورودی نامعتبر را بیصدا میپذیرد و به بخش دیگری از برنامه میفرستد، هنوز خواسته شما را کامل اجرا نکرده است، حتی وقتی ظاهر کد مرتب باشد. این رفتار را حتماً جداگانه بررسی کنید.
کار شما | چه چیزی را مقایسه کنید؟ | شاهد مورد نیاز |
|---|---|---|
یادگیری یک مفهوم | توضیح قابل فهم و قابل بررسی | مثالی که خودتان نتیجهاش را پیشبینی کنید |
تولید تابع | پایبندی به ورودی و خروجی تعیینشده | اجرای تستهای مستقل روی کد |
رفع خطا | تشخیص علت و دامنه اصلاح | تغییر کد و تست بازگشت خطا |
تغییر پروژه موجود | کار با فایلها و حفظ رفتار قبلی | فهرست تغییرات و گزارش تست پروژه |
سرعت را هم دقیق تعریف کنید، چون زمان رسیدن به کدی که اجرا میشود با زمان ظاهر شدن نخستین جمله فرق دارد. پاسخی که سریع میرسد ممکن است به اصلاح دستی نیاز داشته باشد. این زمان را کنار نتیجه ثبت کنید تا انتخابتان به ظاهر پاسخ وابسته نماند.
برای مقایسه اولیه، کاری محدود از پروژه خود انتخاب کنید که جوابش را میشناسید و همان درخواست را بدون تغییر نگه دارید. اگر توضیح مسئله را برای هر ابزار عوض کنید، دیگر نمیتوانید علت تفاوت خروجیها را تشخیص دهید.
مدل با ابزار کدنویسی فرق دارد
مدل پاسخ را تولید میکند و ابزار کدنویسی همان پاسخ را در جریان کار شما به کار میگیرد. Agent یا عامل کدنویسی میتواند با مجوز شما فایل بخواند، تغییر پیشنهاد کند و فرمان اجرا کند. محیط توسعه یا IDE هم جایی است که کد و ابزارهای پروژه را کنار هم دارید.
چت جی پی تی و Claude در کدام بخش کار قرار میگیرند؟
Codex (کدکس) با مخزن و فایلهای پروژه کار میکند و مسیرش از گفتوگو در ChatGPT (چت جی پی تی) جداست. در مستندات رسمی، GPT-6.1 Sol برای حسابهای واجد شرایط Codex معرفی شده است. پیش از شروع، در همان محیط ببینید حساب شما کدام مدلها را در دسترس دارد و نام مدل را از همانجا بردارید.
Claude (کلاد) نام خانواده مدلها و سرویس است و Claude Code ابزار کار روی پروژه. صفحه قیمت Anthropic آن را در Pro ذکر میکند و مستندات مدل، Sonnet 5.5 را معرفی میکنند. در پلازیو پلنهای Pro و Max به Claude Code دسترسی دارند.
مثلاً برای اصلاح تابع سبد خرید میتوانید متن تابع را در چت بفرستید و پاسخ را خودتان منتقل کنید، اما در مسیر عامل، فایل پروژه خودش موضوع کار است. هنگام مقایسه باید معلوم باشد کدام مسیر را انتخاب کردهاید، چون این تفاوت زحمت بازبینی شما را تغییر میدهد.
Cursor و GitHub Copilot هم مدل ثابتی نیستند. مستندات Cursor از کار روی مخزن و بازبینی تغییرات میگویند و GitHub برای Copilot پیشنهاد کد، گفتوگو و وظایف عامل را شرح میدهد. در مقایسه، مدل و محیط را مشخص کنید.
GLM در Claude Code و جمنای در ترمینال
یک ابزار میتواند به ارائهدهنده دیگری متصل شود. نمونه روشن آن استفاده از GLM در Claude Code است که Z.ai برایش راهنمای رسمی دارد. در این حالت نام برنامه ثابت میماند، اما پاسخ از GLM میآید، پس نام ابزار، هویت مدل را ثابت نمیکند.
مستندات اتصال Z.ai در توضیح نگاشت پیشفرض، GLM-5.3-Flash را آوردهاند، اما نمونه تنظیم دستی همان صفحه برای بعضی نامها GLM-5.3 را نشان میدهد. به همین دلیل تنظیم واقعی را بررسی کنید، چون دیدن نام Sonnet در رابط دلیل استفاده از مدل Anthropic نیست.
Gemini (جمنای) در فارسی جمینی یا جمینای هم نوشته میشود. Gemini CLI ابزار خط فرمان است، یعنی درخواست را در ترمینال پروژه میفرستید. نام مدلی که در صفحه اشتراک چت معرفی شده، بهتنهایی مدل فعال CLI را مشخص نمیکند و باید آن را از همان نشست ثبت کنید.
مسیر مقایسه | مدل یا خانواده پاسخدهنده | چه چیزی باید ثبت شود؟ |
|---|---|---|
Claude Code با حساب Anthropic | Claude، با نسخه انتخابشده | مدل واقعی و دسترسی حساب |
Claude Code متصل به Z.ai | GLM | ارائهدهنده و نگاشت مدل |
Codex با حساب ChatGPT | مدل مجاز همان حساب | شناسه مدل و تنظیم استدلال |
Gemini CLI با ورود Google | خانواده Gemini | مدل نشست و نوع حساب |
برای مثال، عوض کردن ارائهدهنده در Claude Code یعنی دو مدل را در محیطی نزدیکتر مقایسه میکنید، هرچند تفاوت تنظیمات باقی میماند. برای مراحل اتصال، راهنمای اتصال GLM به Claude Code را بخوانید.
شرایط یک مقایسه قابل تکرار
نمونه مشترک این مقاله یک تابع پایتون است. موضوع را عمداً محدود انتخاب کردهایم تا بتوان خروجی را با محاسبه روشن سنجید، اما این نمونه عملکرد ابزار در یک پروژه بزرگ را نشان نمیدهد و برای آن باید مسئلهای از همان پروژه تعریف کنید.
پیش از ارسال درخواست، متن خواستهها را در SPEC.md نگه دارید و فایل آغازین را ثابت کنید. نسخه پایتون و ابزار را بنویسید و نام مدل، سطح استدلال و نوع ورود به حساب را هم ثبت کنید، چون شباهت نام تنظیمات در دو سرویس برابری شرایط را ثابت نمیکند.
برای اجرای مقایسه، این ترتیب را دنبال کنید:
برای هر ابزار پوشه و نشست تازهای بسازید و همان فایلهای آغازین را در اختیارش بگذارید.
پس از دریافت پاسخ اول، نسخه کد را نگه دارید و تستهای از پیش تعیینشده را روی آن اجرا کنید.
در صورت شکست، گزارش عینی تست را با درخواست اصلاح یکسان بفرستید و نتیجه این نوبت را جدا ثبت کنید.
پیش از نتیجهگیری، تفاوت فایلها و خروجی ترمینال را خودتان بررسی کنید و اجرای مستقل را تکرار کنید.
در طرح این نمونه هر وظیفه سه تکرار مستقل دارد و ترتیب ابزارها باید جابهجا شود. یک پاسخ موفق ثبات عملکرد را ثابت نمیکند و شکست یک نوبت هم برای کنار گذاشتن همیشگی ابزار کافی نیست.
اطلاعات زمینه یا Context، همان کد و توضیحاتی است که در اختیار مدل قرار میگیرد و باید ثابت بماند. وقتی فایل اعتبارسنجی را به یک ابزار میدهید و برای دیگری حذف میکنید، بخشی از تفاوت پاسخها از اطلاعات ورودی میآید و دیگر نمیتوانید آن را به مدل نسبت دهید.
نمونه مشترک کدنویسی: تابع سبد خرید
فرض کنید سبد خریدی با قیمت و تعداد کالا دارید. تابع باید جمع اولیه، مبلغ پس از تخفیف و تعداد کل کالاها را برگرداند. عددها واحد فرضی دارند و این مثال به قیمت محصولات فروشگاه ربطی ندارد.
درخواست زیر را بدون تغییر به هر گزینه بدهید و نام فایل و تابع را هم ثابت نگه دارید:
«در Python نسخه ۳٫۱۲ و فقط با کتابخانه استاندارد، تابع calculate_total(items, discount) را در cart.py بنویس. items باید list باشد و هر عضو آن dict با کلیدهای price و qty باشد. price عدد صحیح غیرمنفی و qty عدد صحیح مثبت باشد. مقدار bool برای آنها مجاز نیست.»
«discount باید عدد صحیح از صفر تا صد باشد و bool پذیرفته نشود. برای نوع نادرست، کلید گمشده یا مقدار نامعتبر، ValueError بده. کلیدهای اضافی را نادیده بگیر و ورودی را تغییر نده. خروجی یک tuple به ترتیب subtotal، payable و count باشد.»
«subtotal جمع حاصلضرب قیمت در تعداد هر سطر است. payable با فرمول زیر محاسبه شود. count جمع تعدادها باشد و برای لیست خالی، هر سه مقدار صفر باشند. وابستگی اضافه نکن و قرارداد و تستهای موجود را تغییر نده.»
payable = subtotal * (100 - discount) // 100
اکنون مثال مرجع را مشخص کنید. سطر اول قیمت ۱۰۰ و تعداد ۱ دارد و سطر دوم قیمت ۸۵ و تعداد ۲. با تخفیف ۱۰ درصد، خروجی درست (270, 243, 3) است، یعنی subtotal برابر ۲۷۰، payable برابر ۲۴۳ و count برابر ۳. این خروجی از قرارداد مسئله به دست میآید.
درستی پاسخ را با همین مثال تمام نکنید، چون ممکن است کد برای این ورودی جواب درست بدهد و تخفیف نامعتبر را بپذیرد. آن رفتار هم بخشی از مسئله است.
دوازده سناریو برای سنجیدن کد تولیدشده
پیش از دیدن پاسخ ابزار، معیار قبولی را تعیین کنید. در این نمونه ۱۲ سناریو داریم و هر ردیف فقط وقتی قبول است که همه حالتهای نوشتهشده در آن درست باشند. پس تعداد بررسیهای جزئی را با تعداد سناریوها اشتباه نگیرید.
سناریو | خروجی یا رفتار مورد انتظار |
|---|---|
۱. سبد خالی | هر سه مقدار خروجی صفر باشد. |
۲. یک سطر با تعداد یک | جمع قیمت و تعداد درست باشد. |
۳. چند سطر با تعداد متفاوت | مثال مرجع، ۲۷۰ و ۲۴۳ و ۳ را برگرداند. |
۴. تخفیف صفر | مبلغ پرداختی با جمع اولیه برابر باشد. |
۵. تخفیف صد درصد | مبلغ پرداختی صفر باشد. |
۶. نتیجه تخفیف غیرصحیح | قیمت ۱۰۱ با تعداد یک و تخفیف ۳۰ درصد، مبلغ ۷۰ بدهد. |
۷. قیمت صفر | سطر معتبر بماند و تعدادش محاسبه شود. |
۸. قیمت نامعتبر | منفی، رشته و bool با ValueError رد شوند. |
۹. تعداد نامعتبر | صفر، منفی، رشته و bool با ValueError رد شوند. |
۱۰. تخفیف نامعتبر | خارج از بازه، رشته، float و bool با ValueError رد شوند. |
۱۱. ساختار ورودی | ورودی غیر list، عضو غیر dict و کلید گمشده رد شوند، اما کلید اضافی پذیرفته شود. |
۱۲. حفظ ورودی | ساختار و مقادیر ورودی پس از اجرا تغییر نکنند. |
این جدول معیار بررسی پاسخهاست و نتیجه هیچ سرویسی نیست. برای نمونه، پرداخت ۷۰ در ردیف تخفیف از فرمول تعیینشده میآید و گرد کردن دلخواه پاسخ دیگری میسازد، پس باید همین تفاوت را در کد پیدا کنید.
تست پیشنهادی خود مدل هم مفید است، اما تست مستقل معیار قبولی باقی میماند. پاسخ نباید برای عبور از بررسی، مقدار مورد انتظار یا قرارداد را تغییر دهد، چون چنین تغییری حل مسئله محسوب نمیشود.
نمونه رفع خطا: چرا جمع سبد خرید اشتباه است؟
برای سنجیدن هوش مصنوعی برای رفع خطای کد، از فایل معیوب یکسان شروع کنید. اعتبارسنجی ورودی در این نمونه سالم فرض شده و فقط شمارش تعداد کل کالاها اشکال دارد، بنابراین بازنویسی اعتبارسنجی بخشی از خواسته نیست.
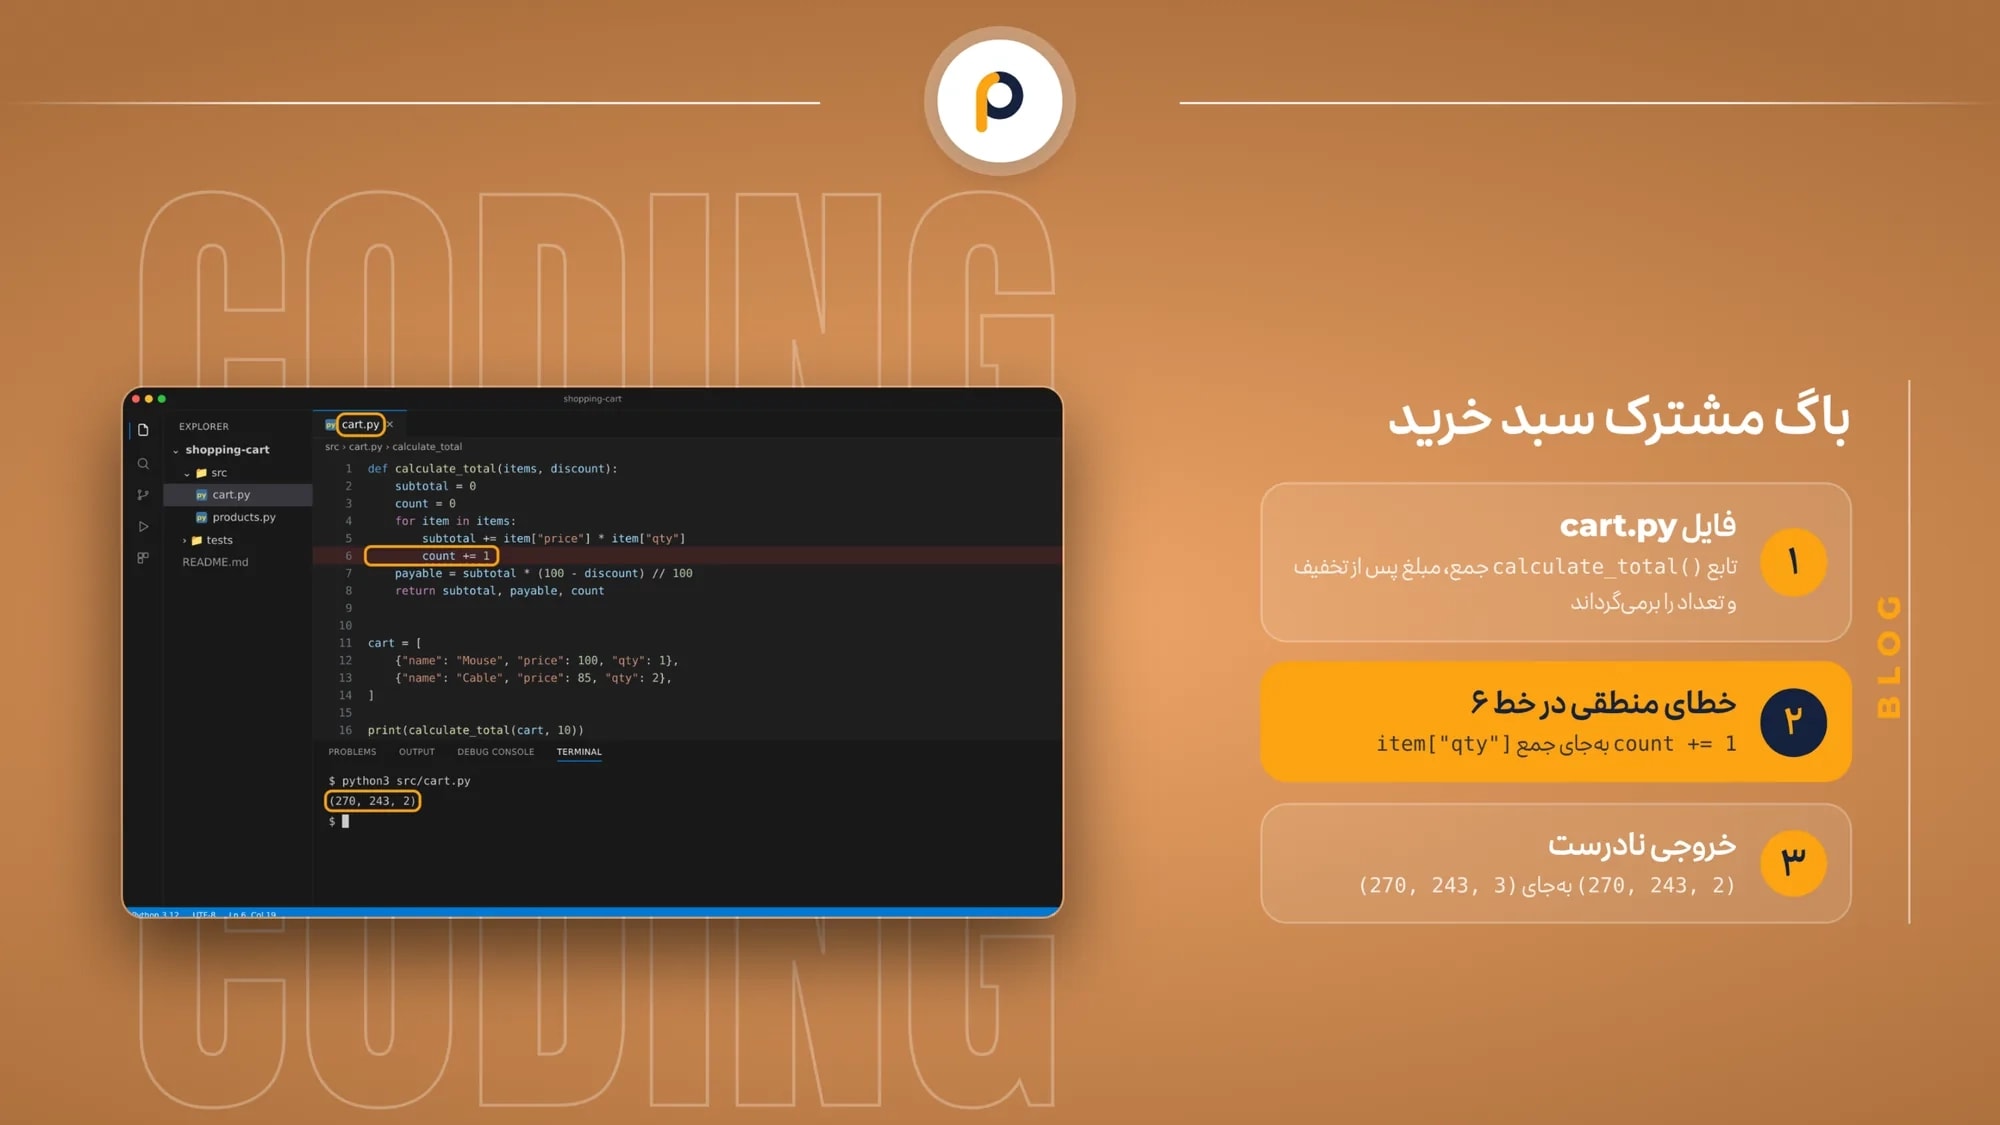
در فایل معیوب، خط ۶ داخل حلقه برای هر سطر فقط یک واحد به تعداد اضافه میکند:
count += 1
در نتیجه تعداد سطرها شمرده میشود، نه تعداد کالاها. با ورودی قبلی، خروجی معیوب (270, 243, 2) است، در حالی که قرارداد (270, 243, 3) را میخواهد. جمع اولیه و مبلغ پرداختی درستاند و اختلاف فقط در عدد سوم است. تست test_multiple_rows همین اختلاف را گزارش میکند.
درخواست مشترک رفع خطا را چنین بنویسید: «قرارداد و cart.py را بخوان. خروجی مورد انتظار و خروجی فعلی بالا را مقایسه کن، علت خطا را توضیح بده و اصلاح حداقلی پیشنهاد کن. اعتبارسنجی و تستهای موجود را تغییر نده. تستی بنویس که برگشت همین خطا را آشکار کند.»
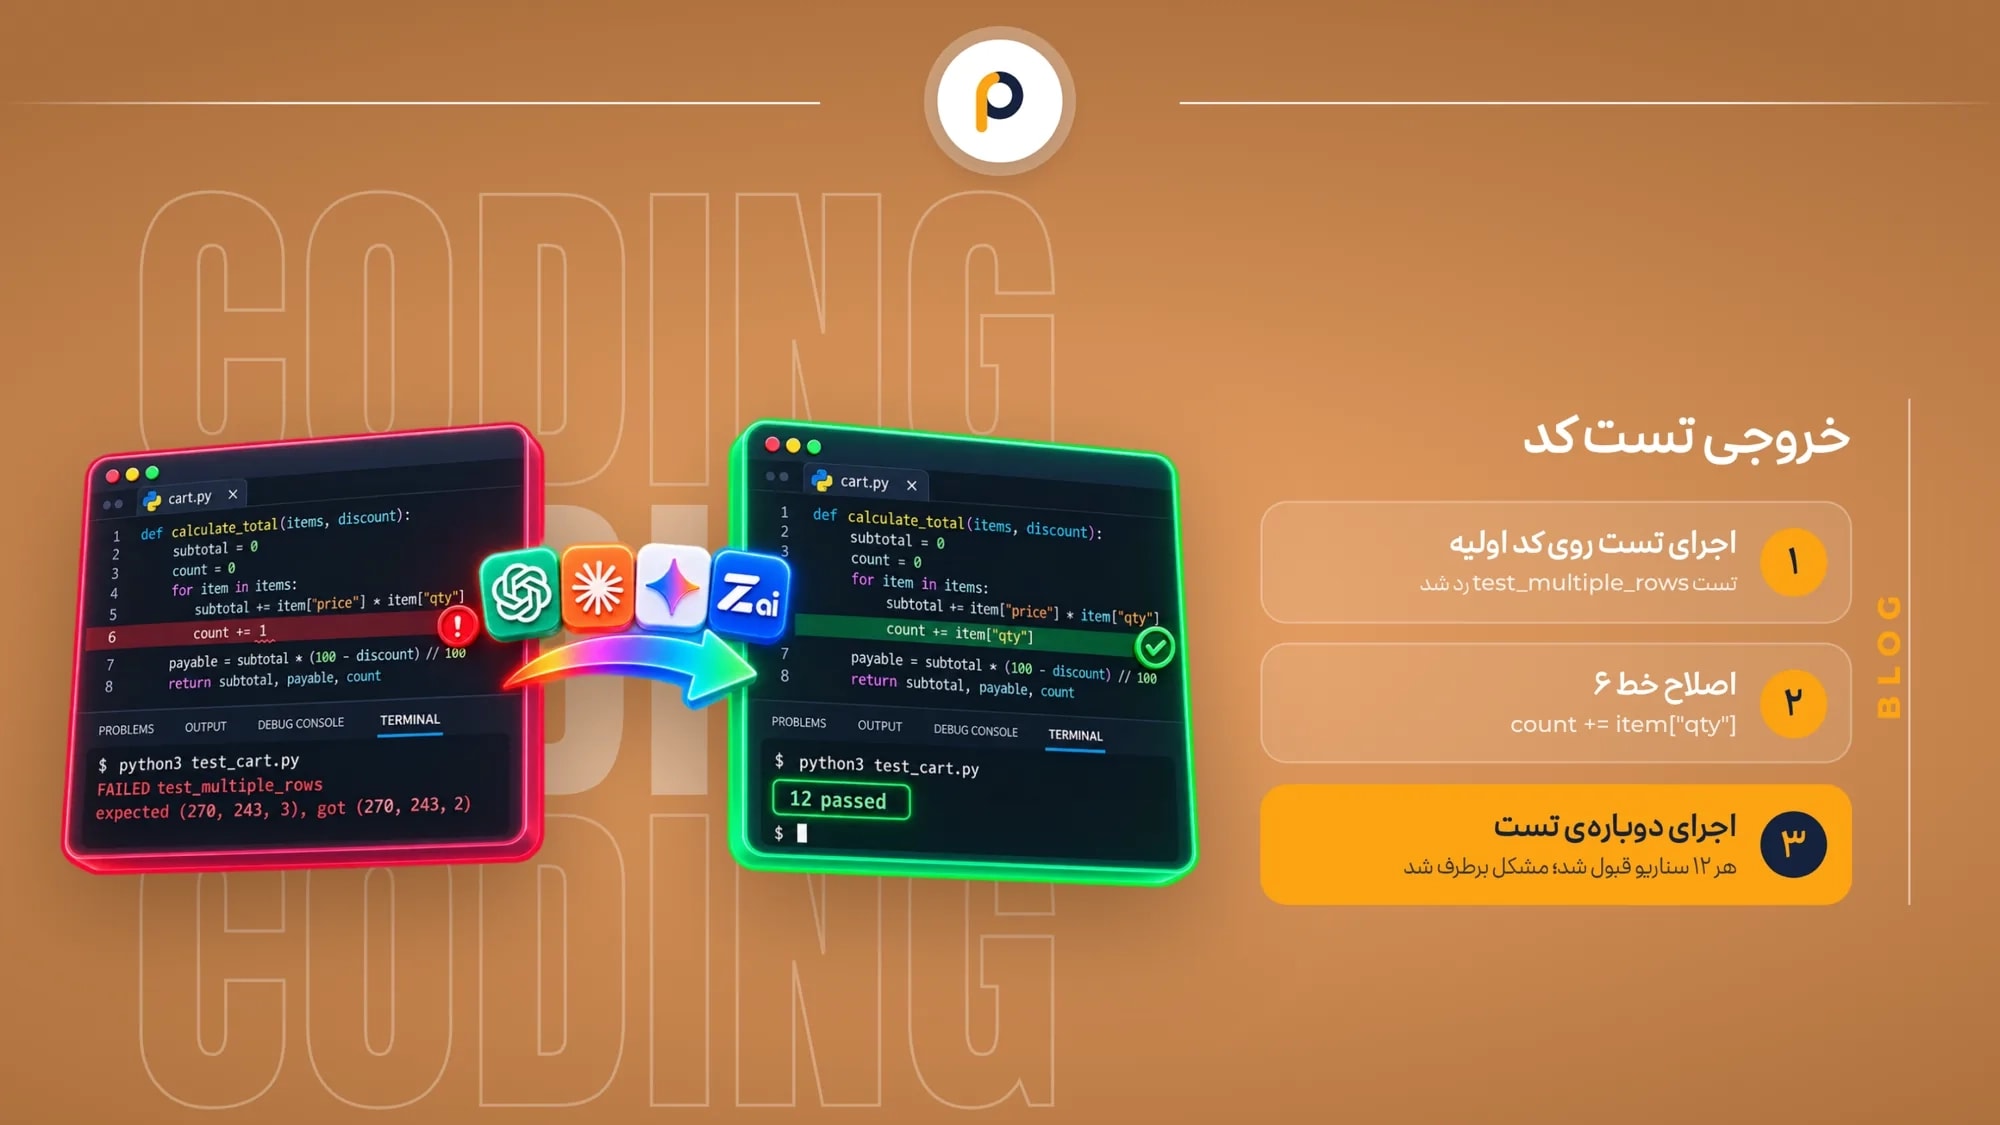
اصلاح مرجع خط ۶، عبارت زیر است:
count += item["qty"]
با این تغییر، تعداد هر سطر به جمع اضافه میشود. تعداد کالا با تعداد سطر فرق دارد. این عبارت اصلاح مرجع آموزشی است و به Claude، GLM یا ابزار دیگری تعلق ندارد. پس از اصلاح، هر ۱۲ سناریو باید دوباره قبول شوند.
توضیح قابل قبول باید علت را بشناسد و بعد از آن همان تستهای قبلی دوباره اجرا شوند. ثابت کردن عدد سوم روی ۳ فقط نمونه را ظاهراً درست میکند و قاعده محاسبه را اصلاح نمیکند.
پاسخها را چطور کنار هم بخوانیم؟
در مقایسه ChatGPT و Claude برای برنامه نویسی، نام برند بهتنهایی شاهد نیست و باید خروجی همان وظیفه را در همان محیط ببینید. این اصل درباره Gemini و GLM هم برقرار است، پس برنده تولید کد یا رفع خطا را باید از اجرای خودتان بیرون بکشید و نه از نام ابزار.
پس از اجرای شخصی، برای هر مسیر یک ردیف ثبت کنید. تعداد سناریوهای قبولشده در پاسخ اول را از نتیجه نوبت اصلاح جدا بنویسید، زمان رسیدن به فایل قابل اجرا را نگه دارید و هر تغییر خارج از خواسته را هم توضیح دهید.
فرض کنید پاسخ، شمارش تعداد را اصلاح کرده، اما برای محاسبه ساده سبد خرید کتابخانه تازهای افزوده است. پاسخ با قرارداد سازگار نیست. پذیرفتن این تغییر بدون بررسی، مقایسه شما را به پسندیدن ظاهر راهحل محدود میکند.
در توضیح خطا دنبال شاهد بگردید. اشاره روشن به اشتباه گرفتن تعداد سطر با تعداد کالا در خط ۶ قابل بررسی است، اما عبارت مبهمی مثل «منطق محاسبه اصلاح شد» علت را روشن نمیکند. برای یادگیری، همین تفاوت ارزش دارد.
این مسئله محدود، معماری نرمافزار یا کار با مخزن چندفایلی را نمیسنجد و اجرای آن با عاملهای متفاوت هم مقایسه کل جریان کار است. نتیجه را به همه زبانها تعمیم ندهید.
برای بهکارگیری GLM در ابزارهای پشتیبانیشده، میتوانید پلنهای اشتراک Z.ai برای کدنویسی را بررسی کنید. در پلازیو پلنهای Lite، Pro و Max با مدت ۱ یا ۳ ماه روی ایمیل شخصی شما فعال میشوند و فعالسازی ظرف ۱ تا ۳ ساعت انجام میشود.
هزینه اشتراک، سهمیه و API را جدا حساب کنید
یک درخواست شما ممکن است به چند فراخوانی مدل منجر شود، بنابراین تعداد پیام، Credit و درخواست مدل واحد مشترکی ندارند. جدول زیر قیمتهای رسمی سازندگان را در بازبینی ۱۱ آبان ۱۴۰۵ نشان میدهد. این ارقام قیمت پلازیو نیستند و منابع رسمی در پایان آمدهاند.
اشتراک | قیمت رسمی دلاری | نکته مرتبط با کدنویسی |
|---|---|---|
ChatGPT Plus | ۲۰ دلار آمریکا در ماه، طبق مستندات قیمت OpenAI | Codex را شامل میشود، اما مصرف API مسیر جدا دارد. |
Claude Pro | ۲۰ دلار آمریکا با پرداخت ماهانه، طبق صفحه قیمت Anthropic | Claude Code در فهرست امکانات آن است. |
Google AI Pro | ۱۹٫۹۹ دلار آمریکا در ماه، طبق صفحه اشتراک Google | سهمیه CLI به نوع ورود و حساب وابسته است. |
GLM Coding Plan | شروع از ۱۸ دلار آمریکا در ماه، طبق مستندات Z.ai | این رقم قیمت پایینترین پلن است و پلنهای بالاتر بیشتر هزینه دارند. |
مستندات Z.ai سهمیه را با Credit در بازه پنجساعته و هفتگی بیان میکنند و آن را نباید به تعداد ثابت پرامپت تبدیل کرد. در مقابل، راهنمای Gemini CLI برای ورود Google سقف روزانه ۱۰۰۰ درخواست مدل در سطح رایگان و ۱۵۰۰ درخواست در Google AI Pro ذکر میکند. درخواست مدل الزاماً یک پیام کاربر نیست.
ارتقای پلن تضمین کیفیت بالاتر کد نیست. برای شناخت تفاوت حجم مصرف پلنها، توضیحات صفحه اشتراک کلاد را بخوانید. اشتراک چت و مصرف API هم مسیرهای جداگانهای دارند.
گزینههای سفارش را در صفحه اشتراک Claude و پلنهای ChatGPT میبینید. اشتراک قانونی Claude در پلنهای Pro و Max روی ایمیل شخصی شما فعال میشود و نوع Pro با فعالسازی کمتر از ۲ ساعت هم دارد که هزینه بیشتری دارد. پلنهای Go و Plus در ChatGPT بهصورت اکانت شخصی یا اکانت آماده سفارش داده میشوند و تحویل تا ۳ ساعت انجام میشود. پرداخت اقساطی از طریق دیجیپی برای همه محصولات ارائه میشود.
انتخاب را به کار روزانهتان وصل کنید
برای یادگیری، از دسترسی فعلی خودتان شروع کنید. مسئلهای بردارید که بتوانید جوابش را بررسی کنید و از مدل توضیح بخواهید. مثلاً پیش از اجرای تابع سبد خرید، تعداد کل را خودتان حساب کنید و بعد درباره علت اختلاف سؤال بپرسید.
در پروژه موجود، بازبینی تغییرات فایل اهمیت بیشتری پیدا میکند. Diff تفاوت نسخه قبلی و جدید کد را نشان میدهد. پیش از پذیرفتن پاسخ، ببینید عامل کدام فایلها را عوض کرده و آیا تستهای قبلی همچنان برقرارند، چون اصلاح تابعی که بخش دیگری از پروژه به آن وابسته است، به بررسی همان وابستگی هم نیاز دارد.
برای استفاده مداوم، برخورد واقعی با محدودیت را ثبت کنید. شاید نیاز اصلی شما توضیح چند قطعه کد باشد و شاید عامل در طول کار مرتب به سهمیه برسد. این دو وضعیت دلیل یکسانی برای خرید اشتراک نیستند و باید جدا بررسی شوند.
نام GLM برای کدنویسی زمانی در انتخاب شما معنا دارد که ابزار پشتیبانیشده و مسیر مصرفش با کارتان جور باشد. در Gemini برای کدنویسی هم حساب چت و CLI را تفکیک کنید، چون عنوان اشتراک بهتنهایی کافی نیست.
برای امتحان کردن مسیر GLM، جزئیات اشتراک Z.ai را با ابزار مورد استفادهتان تطبیق دهید. ابزارهایی مثل Claude Code، Cline، Cursor و ZCode با این اشتراک کار میکنند. اگر هنگام انتخاب پلن سؤالی داشتید، پشتیبانی پلازیو در تلگرام، واتساپ و چت آنلاین پاسخگوست.
پرسشهای رایج درباره هوش مصنوعی کدنویسی
کدام هوش مصنوعی برای برنامهنویسی انتخاب مناسبی است؟
انتخاب به وظیفه شما بستگی دارد. برای توضیح کد، فهمپذیری پاسخ را بسنجید و برای تغییر پروژه، بررسی فایل و تست را هم اضافه کنید. بدون اجرای مشترک نمیتوان برنده عملکردی تعیین کرد.
ChatGPT برای کدنویسی بهتر است یا Claude؟
مدل و محیط مقایسه باید مشخص باشد، چون نتیجه Codex یا Claude Code را نمیتوان به همه پاسخهای چت تعمیم داد. بهتر است همان نمونه مشترک را با هر دو ابزار خودتان اجرا کنید و خروجیها را کنار هم بگذارید.
آیا هوش مصنوعی برنامه نویسی رایگان کافی است؟
برای یادگیری از دسترسی رایگان موجود شروع کنید. راهنمای Gemini CLI ورود رایگان با Google را هم شرح میدهد. وقتی به قابلیت یا سهمیه بیشتری نیاز پیدا کنید، ارتقا معنا پیدا میکند.
بدون یادگیری برنامهنویسی میتوان با AI برنامه ساخت؟
تولید کد با درخواست متنی شروع میشود، اما بررسی آن دانش میخواهد. برای تشخیص خطای نمونه، باید تفاوت تعداد سطر و تعداد کالا را بفهمید و بتوانید نتیجه را بررسی کنید.
آیا هوش مصنوعی جای برنامهنویس را میگیرد؟
این نمونه آینده بازار کار را پیشبینی نمیکند. تعریف خواسته و تأیید نتیجه بر عهده مسئول پروژه است و تولید یک تابع همه کار توسعه نرمافزار را پوشش نمیدهد.
میتوان از GLM در Claude Code استفاده کرد؟
بله، راهنمای رسمی این اتصال وجود دارد. مدل پاسخدهنده GLM است و مصرف به پلن Z.ai مربوط میشود. نام Claude Code به معنی استفاده از مدل Anthropic نیست.
اشتراک ChatGPT همان اعتبار API است؟
خیر، اشتراک و مصرف API دو مسیر جدا دارند. مستندات Codex ورود با ChatGPT و ورود با API key را از هم تفکیک میکنند، پس خرید Plus به معنی دریافت اعتبار عمومی API نیست. از میان پلنهای شخصی ChatGPT، فقط Pro اعتبار ماهانه API جداگانه دارد.
سهمیه Z.ai در ابزارهای مختلف جداست؟
ابزارهای پشتیبانیشده از سهمیه مشترک پلن استفاده میکنند و نصب ابزار دیگر سهمیه مستقلی اضافه نمیکند. مصرف و زمان بازنشانی را در حساب خود ببینید.
منابع
آخرین بهروزرسانی: ۱۱ آبان ۱۴۰۵